Pourquoi la fiabilité produit est devenue un enjeu stratégique
La fiabilité produit désigne la probabilité qu'un produit, un système ou un service remplisse sa fonction prévue de manière adéquate pendant une période définie. Pour toute entreprise qui propose des produits numériques, atteindre un haut niveau de fiabilité est essentiel car cela pèse directement sur la satisfaction et la confiance des utilisateurs. Un panier abandonné après un timeout, une application mobile qui rame pendant un pic de trafic ou une API partenaire qui répond de façon incohérente ont un coût direct sur le chiffre d'affaires et sur la réputation de marque.
Les principes du site reliability engineering, le SRE, offrent un cadre pour y parvenir. Ils marquent un passage des pratiques traditionnelles de gestion des services vers une approche plus proactive, centrée sur la fiabilité et adaptée aux exigences des produits numériques modernes : architectures distribuées, déploiements continus, dépendances cloud multiples et attentes utilisateurs en temps quasi réel.
Les limites de l'ITSM traditionnel face aux produits numériques
Pendant longtemps, les organisations ont mesuré la fiabilité à travers des indicateurs comme la disponibilité des serveurs ou la latence réseau. Le problème est que ces métriques ne reflètent ni la satisfaction client ni l'expérience réelle des utilisateurs. Un serveur peut afficher 99,9 % de disponibilité pendant qu'un parcours de paiement reste dégradé pour une partie des utilisateurs, ou qu'une fonctionnalité clé échoue silencieusement sans déclencher d'alerte infrastructure.
S'appuyer uniquement sur les pratiques ITSM et de monitoring traditionnelles n'est plus viable pour des services numériques complexes, composés de dizaines de microservices, de files d'événements et de dépendances tierces. La voie proposée consiste à combiner l'ITSM avec les pratiques SRE, pour une approche plus complète qui intègre des objectifs de niveau de service, les SLO, et des indicateurs centrés sur le parcours utilisateur plutôt que sur la seule santé de l'infrastructure.
Le SRE, une discipline née chez les hyperscalers désormais généralisée
Le site reliability engineering est né chez Google au début des années 2000, avant de se diffuser largement dans l'ensemble de l'industrie numérique. L'idée fondatrice tient en une phrase : traiter les opérations comme un problème logiciel, en confiant la fiabilité à des ingénieurs qui codent des solutions d'automatisation plutôt que d'exécuter des procédures manuelles répétitives. Cette philosophie s'est depuis largement diffusée bien au-delà des géants du cloud, jusqu'aux plateformes e-commerce de taille moyenne et aux directions des systèmes d'information du secteur public.
En 2026, le SRE ne se limite plus aux grandes plateformes web : il structure désormais la fiabilité des plateformes de paiement, des systèmes de santé numérique et des chaînes logistiques connectées, partout où l'indisponibilité a un coût métier direct et mesurable.
Les sept principes fondamentaux du SRE
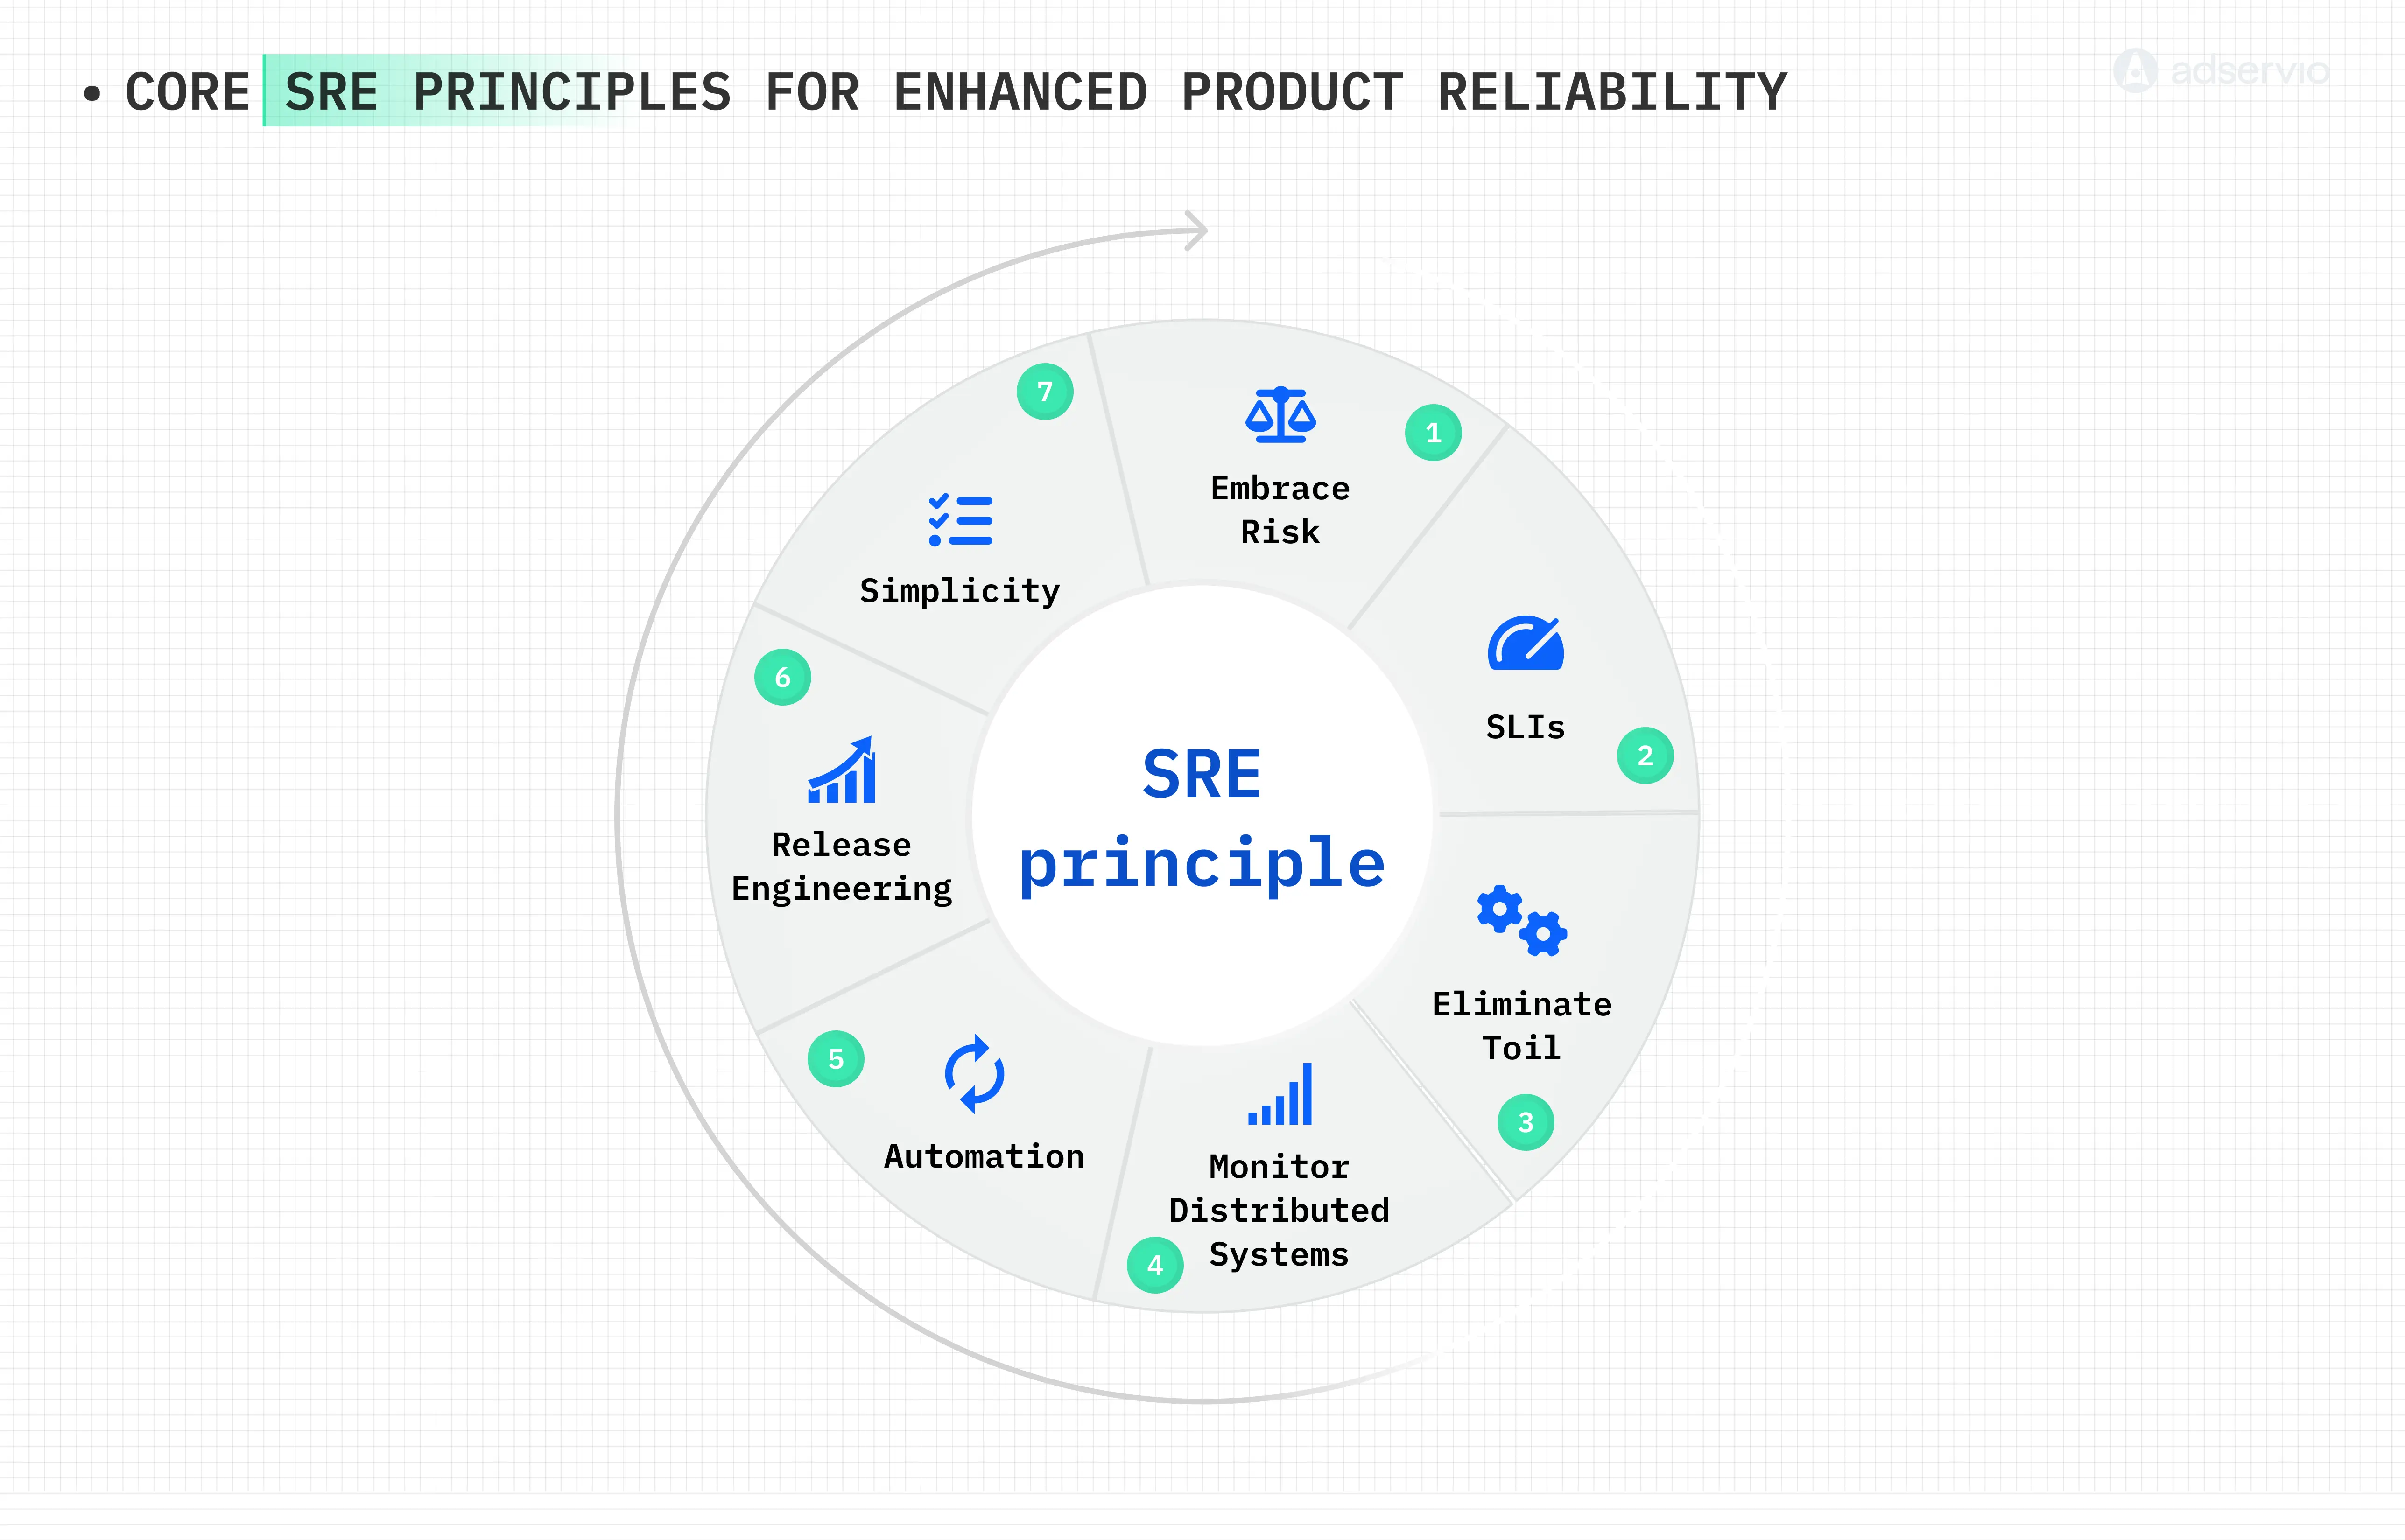
Le SRE repose sur sept principes qui se renforcent mutuellement. Ils ne s'appliquent pas isolément : c'est leur combinaison, tenue dans la durée, qui transforme la fiabilité d'un vœu pieu en discipline mesurable.
Accepter le risque et mesurer avec les SLI
Le premier principe consiste à accepter le risque : plutôt que de viser une fiabilité absolue, illusoire et coûteuse, on équilibre le risque à l'aide d'un budget d'erreur qui mesure le niveau de downtime acceptable sur une fenêtre donnée, souvent trente ou quatre-vingt-dix jours glissants. Le deuxième principe mobilise les service-level indicators, les SLI, ces métriques mesurables, comme le taux de succès des requêtes ou la latence au 95e percentile, qui nourrissent les SLO et évaluent objectivement la fiabilité perçue par l'utilisateur.
Éliminer le toil pour réinvestir le temps ingénieur
Le troisième principe vise à éliminer le toil, c'est-à-dire les tâches répétitives, manuelles et sans valeur ajoutée durable, comme la gestion des accès, la création de comptes ou le redémarrage manuel de services, en les automatisant ou en les supprimant. Un objectif courant chez les équipes SRE matures est de plafonner le toil à moins de 50 % du temps ingénieur, le reste étant consacré à des projets d'ingénierie qui réduisent durablement la charge opérationnelle.
Superviser, automatiser et industrialiser les releases
Les principes suivants complètent l'édifice. La supervision des systèmes distribués permet de détecter les incidents qui compromettent la fiabilité, comme les pannes réseau, la saturation de ressources ou les régressions de performance après un déploiement. L'automatisation des processus répétitifs améliore l'efficacité et réduit les coûts opérationnels. Le release engineering industrialise le lancement des services, via des déploiements progressifs de type canary ou blue-green, pour livrer des mises à jour cohérentes et réversibles.
Rechercher la simplicité
Enfin, la recherche de simplicité réduit la complexité accidentelle, principale source d'erreurs opérationnelles et d'incidents en cascade, au profit d'une architecture plus lisible et d'une expérience d'exploitation plus robuste. Chaque composant ajouté sans justification claire est un point de défaillance supplémentaire à superviser, documenter et faire évoluer.
Construire l'organisation : la tiger team dédiée à la fiabilité
Aucun principe SRE ne produit d'effet durable sans une organisation qui le porte. La mise en œuvre débute généralement par la constitution d'une tiger team, une équipe resserrée et pluridisciplinaire dotée d'une expertise en gestion d'incidents et en fiabilité. Elle réunit typiquement des profils d'infrastructure, des ingénieurs en automatisation, des spécialistes de la supervision et des développeurs qui connaissent le produit de l'intérieur.
Leur mandat est clair : suivre les SLO au quotidien, arbitrer les changements à risque et prévenir les incidents en production en mesurant en continu le temps moyen de détection et de résolution. Cette équipe agit comme un pont entre les développeurs, focalisés sur la livraison de fonctionnalités, et les opérations, focalisées sur la stabilité, sans jamais devenir un silo supplémentaire qui ralentirait les livraisons.
Une implémentation en quatre étapes
Une fois l'équipe en place, l'implémentation suit un chemin en quatre étapes, séquencées mais itératives, qui évite l'écueil classique de vouloir tout mesurer et tout automatiser dès le premier mois.
Étape 1 : constituer la tiger team et cadrer le périmètre
La première étape formalise la tiger team décrite plus haut et choisit un périmètre pilote : un produit ou un parcours critique unique, plutôt que l'ensemble du portefeuille applicatif. Ce choix délibérément restreint permet d'apprendre vite et de démontrer une valeur mesurable avant d'étendre l'effort.
Étape 2 : définir des SLO et des SLI clairs
La deuxième étape consiste à définir des SLO et des SLI clairs, en identifiant les composants et les métriques à suivre pour évaluer la disponibilité, la latence et le taux d'erreur du point de vue de l'utilisateur final, et non plus seulement de l'infrastructure sous-jacente.
Étape 3 : renforcer la fiabilité opérationnelle
La troisième étape améliore concrètement la fiabilité par une approche multidimensionnelle : renforcer la gestion d'incidents, mener des revues post-incident approfondies et sans recherche de coupable, automatiser les incidents routiniers de faible complexité, documenter les réponses dans des runbooks et réviser l'architecture des points les plus fragiles, avec un accent particulier sur une gestion efficace des changements et des releases.
Étape 4 : évaluer l'impact et étendre la démarche
La quatrième étape, après environ six mois ou six cycles de SLO, évalue l'impact réel sur la fiabilité, analyse l'efficacité de la tiger team au regard d'indicateurs comme le MTTR ou la fréquence de changement, et étend ensuite l'approche aux autres produits du portefeuille, produit par produit plutôt que d'un coup.
Mesurer, itérer et industrialiser la démarche SRE
Le SRE n'est pas un projet ponctuel mais une discipline d'amélioration continue. Les SLO doivent être revus à intervalles réguliers, en général chaque trimestre, pour rester alignés avec les attentes réelles des utilisateurs et les évolutions du produit. Un budget d'erreur épuisé trop vite signale qu'il faut ralentir les livraisons au profit de la stabilité ; un budget d'erreur jamais consommé indique au contraire un SLO trop conservateur, qui freine inutilement l'innovation.
Cette instrumentation régulière transforme les revues post-incident en matière première d'amélioration continue et permet de justifier, chiffres à l'appui, les investissements en fiabilité auprès des directions produit et métier, souvent plus sensibles au ROI qu'aux arguments purement techniques. Un tableau de bord de fiabilité partagé, incluant SLO, budget d'erreur consommé et tendance sur les derniers trimestres, devient alors un langage commun entre équipes techniques et décideurs.
Vers un SRE augmenté par l'IA en 2026
L'année 2026 marque un tournant pour la discipline : les plateformes d'observabilité intègrent désormais des agents IA capables de corréler automatiquement des milliers de signaux, de proposer un diagnostic de cause racine en quelques secondes et de déclencher des remédiations pré-validées sur les incidents de faible complexité. Des protocoles standardisés facilitent l'échange contextualisé entre ces agents et les outils de supervision, de ticketing et de déploiement.
Cette automatisation ne remplace pas les sept principes du SRE : elle en accélère l'exécution, en réduisant le toil résiduel et en libérant les ingénieurs pour les décisions qui requièrent un vrai jugement métier. Chez Adservio, nous accompagnons les équipes dans l'adoption de ces principes, outillés par l'IA quand elle apporte une valeur mesurable, pour bâtir des produits durablement fiables.
RÉCUPÉRER CET ARTICLE
Téléchargez l'article complet en PDF pour le lire hors ligne ou le partager.
RESTER INFORMÉ
Recevez nos prochaines analyses et retours d'expérience directement dans votre boîte mail.