Pourquoi coupler moteurs de workflow et microservices
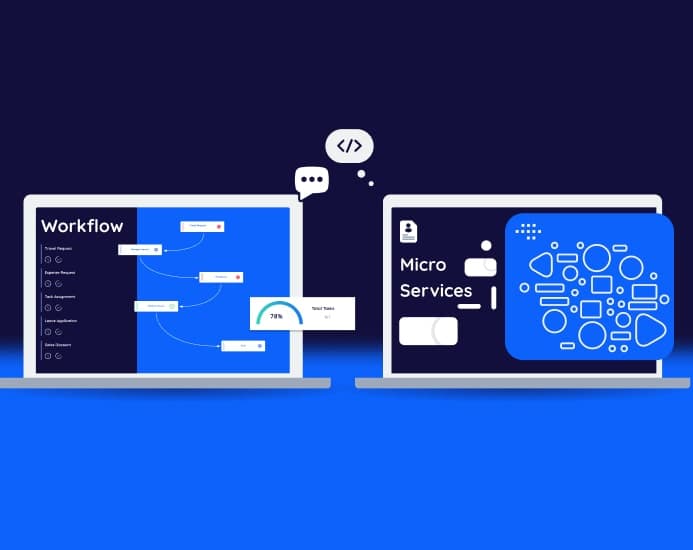
Moteurs de workflow et microservices permettent aux entreprises d'associer l'amélioration de leurs processus à leur transformation numérique, un atout pour rester compétitives dans un environnement où l'automatisation s'impose.
Encore faut-il les mettre en œuvre correctement. La difficulté est réelle : une large majorité d'entreprises peinent encore à tenir la promesse d'un modèle d'affaires porté par la technologie, faute d'une architecture pensée pour absorber la complexité des processus métier réels.
Ce dossier détaille les freins organisationnels les plus courants, les trois stratégies de conception qui rendent un couple moteur de workflow / microservices réellement robuste, l'anatomie d'un moteur d'orchestration moderne et les leviers de gouvernance qui évitent de reconstruire, sous une autre forme, les silos que l'on cherchait à éliminer.
Les freins organisationnels qui bloquent la transformation
Quatre obstacles reviennent le plus souvent lorsqu'une organisation tente de connecter ses processus métier à une architecture applicative modernisée.
Les silos organisationnels et applicatifs
Des équipes déconnectées créent une fragmentation des processus et des données. Chaque département optimise son propre outillage sans visibilité sur les dépendances amont ou aval, ce qui multiplie les ressaisies manuelles et les incohérences entre systèmes.
Une intégration insuffisante des systèmes existants
Les applications internes complexes, souvent héritées de plusieurs générations de systèmes d'information, résistent à toute interconnexion propre. Les intégrations se font alors via des scripts ad hoc ou des exports de fichiers, fragiles et coûteux à maintenir.
Les goulets d'étranglement dans les processus
Des étapes lentes ou manuelles dégradent l'expérience client et ralentissent le temps de traitement de bout en bout, en particulier lorsque des validations humaines s'intercalent sans automatisation des relances ni des escalades.
La redondance de processus et de données
Processus et données dupliqués font baisser la qualité globale du système : deux équipes retraitent la même information sans référentiel commun, ce qui génère des divergences difficiles à réconcilier a posteriori.
C'est précisément ce que l'association d'un moteur de workflow et de microservices permet d'attaquer, à condition de respecter quelques principes de conception éprouvés.
Trois stratégies de conception pour des microservices robustes
Trois stratégies de conception structurent la plupart des mises en œuvre réussies. La première est le principe de responsabilité unique, qui borne le périmètre fonctionnel de chaque microservice. La deuxième est la communication asynchrone, qui découple les services les uns des autres dans le temps. La troisième est le fail fast, qui isole les défaillances avant qu'elles ne se propagent en cascade.
Ces trois piliers ne s'appliquent pas indépendamment : un moteur de workflow bien conçu orchestre des microservices à responsabilité unique, communiquant de façon asynchrone, et protégés par des mécanismes de tolérance aux pannes. Les chapitres suivants détaillent chacune de ces stratégies avec des exemples concrets d'implémentation.
Le principe de responsabilité unique en pratique
Le principe de responsabilité unique veut que chaque microservice prenne en charge une seule fonction métier précise, avec son propre modèle de données et son propre cycle de déploiement.
Définir le bon grain de service
Trouver le bon niveau de granularité est l'exercice le plus délicat. Un service trop fin multiplie les appels réseau et la latence cumulée ; un service trop large recrée un monolithe déguisé en microservices, couplé en interne et impossible à faire évoluer indépendamment. Le domain-driven design, et en particulier la notion de bounded context, reste la boussole la plus fiable pour tracer ces frontières.
Étude de cas : un système de commande de chaussures
Sur un système de commande de chaussures en ligne, on prévoira ainsi des services distincts pour la commande, la gestion du stock, le paiement et les notifications de livraison, plutôt qu'un unique service surchargé qui centraliserait toute la logique. Chaque service peut alors évoluer, être testé et déployé séparément, avec son propre rythme de release.
Éviter l'anti-pattern du service fourre-tout
Le piège le plus fréquent est le service god object : un composant censé être unique en responsabilité qui absorbe, au fil des sprints, des fonctionnalités annexes par facilité. Un audit régulier des dépendances entre services et des revues d'architecture permettent de détecter cette dérive avant qu'elle ne coûte cher à corriger.
Communication asynchrone et architecture événementielle
La communication asynchrone laisse les services opérer indépendamment, sans attendre de réponse immédiate, ce qui empêche un composant lent d'arrêter tout le workflow et laisse les processus se poursuivre pendant que les services dépendants terminent leurs tâches.
Message brokers et event streaming
Des plateformes comme Apache Kafka, RabbitMQ ou les services managés type Amazon EventBridge et Google Pub/Sub servent de colonne vertébrale à cette architecture événementielle. Chaque microservice publie des événements représentant les changements d'état métier, et les services intéressés s'y abonnent sans connaître l'émetteur.
Le pattern saga pour les transactions distribuées
Lorsqu'un workflow traverse plusieurs microservices avec leurs bases de données propres, une transaction ACID classique n'est plus possible. Le pattern saga découpe la transaction en une séquence d'étapes locales, chacune assortie d'une action de compensation permettant d'annuler proprement les étapes déjà exécutées en cas d'échec en aval.
Le pattern outbox pour garantir la cohérence
Publier un événement et écrire en base dans la même transaction est un problème classique de cohérence. Le pattern transactional outbox résout ce dilemme en écrivant l'événement dans une table dédiée au sein de la même transaction que la donnée métier, puis en le relayant de façon asynchrone vers le broker via un connecteur de type Debezium.
Fail fast, circuit breakers et tolérance aux pannes
La troisième stratégie est le fail fast au service de la tolérance aux pannes. En mettant en place des circuit breakers, on surveille les appels aux services externes pour y détecter erreurs et dépassements de délai, ce qui prévient la propagation en cascade des défaillances vers les systèmes dépendants.
Les trois états d'un circuit breaker
Un circuit breaker bascule entre trois états : fermé, où les appels passent normalement ; ouvert, où les appels sont immédiatement rejetés dès qu'un seuil d'erreurs est franchi, pour laisser au service en difficulté le temps de récupérer ; et semi-ouvert, où un nombre limité d'appels de test permet de vérifier si le service est de nouveau disponible avant de refermer le circuit.
Retries, backoff exponentiel et bulkheads
Un retry naïf sans délai aggrave souvent l'incident en surchargeant un service déjà fragilisé. Le backoff exponentiel avec jitter espace les tentatives de façon croissante et aléatoire pour éviter les effets de horde. Le pattern bulkhead, lui, cloisonne les pools de ressources par dépendance afin qu'une panne sur un service externe n'épuise pas les threads ou connexions disponibles pour le reste de l'application.
Timeouts et dégradation gracieuse
Fixer des timeouts courts et cohérents à chaque appel inter-service évite les blocages en cascade. Couplés à une dégradation gracieuse, c'est-à-dire une réponse partielle ou une valeur par défaut plutôt qu'une erreur bloquante, ils permettent au workflow global de continuer à produire de la valeur même quand un service périphérique est indisponible.
Anatomie d'un moteur d'orchestration de workflow moderne
Un moteur de workflow s'articule autour de six éléments essentiels, que l'on retrouve, sous des formes variées, dans la plupart des plateformes d'orchestration modernes.
Les six briques d'un moteur d'orchestration
L'exécuteur de tâches lance les actions définies par les microservices. L'ordonnanceur coordonne l'exécution et surveille les résultats. Les déclencheurs assurent une activation pilotée par les événements. Le référentiel de processus stocke les définitions des processus métier. Le contexte partagé permet aux composants d'échanger des informations, et le stockage des métadonnées conserve les instructions d'orchestration nécessaires au bon déroulement des flux.
Orchestration versus chorégraphie
L'orchestration centralise la logique de coordination dans le moteur de workflow, qui sait à tout moment où en est chaque instance de processus, ce qui facilite l'observabilité et la reprise sur erreur. La chorégraphie, à l'inverse, répartit cette logique entre les services eux-mêmes, chacun réagissant aux événements des autres sans chef d'orchestre central. Les architectures les plus matures combinent les deux : chorégraphie pour les réactions locales rapides, orchestration pour les processus métier longs et à forte valeur de traçabilité.
Les moteurs de référence en 2026
Côté outillage, Temporal et Camunda 8 dominent les déploiements orientés développeurs pour leur modèle de workflow-as-code et leur durabilité d'exécution. AWS Step Functions et Azure Logic Apps restent des choix naturels dans un environnement cloud managé, tandis qu'Argo Workflows s'impose pour les pipelines orchestrés nativement sur Kubernetes.
Gouvernance, observabilité et accompagnement Adservio
Associer moteurs de workflow et microservices ne se résume pas à un choix d'outils : la valeur naît de la façon dont on découpe les responsabilités, dont on fait dialoguer les services et dont on isole les défaillances. Mal menée, cette approche recrée les silos et goulets d'étranglement qu'elle prétend supprimer.
L'observabilité de bout en bout, traces distribuées, corrélation des identifiants de workflow à travers les microservices, tableaux de bord unifiés, est la condition pour diagnostiquer rapidement un incident sur un processus qui traverse dix services et trois systèmes hérités. Sans elle, la complexité distribuée se paie en temps de résolution d'incident.
Chez Adservio, nous aidons les organisations à concevoir et orchestrer leurs microservices autour de moteurs de workflow adaptés à leurs processus métier, en appliquant les bonnes pratiques et en évitant les pièges et anti-patterns coûteux.
RÉCUPÉRER CET ARTICLE
Téléchargez l'article complet en PDF pour le lire hors ligne ou le partager.
RESTER INFORMÉ
Recevez nos prochaines analyses et retours d'expérience directement dans votre boîte mail.